

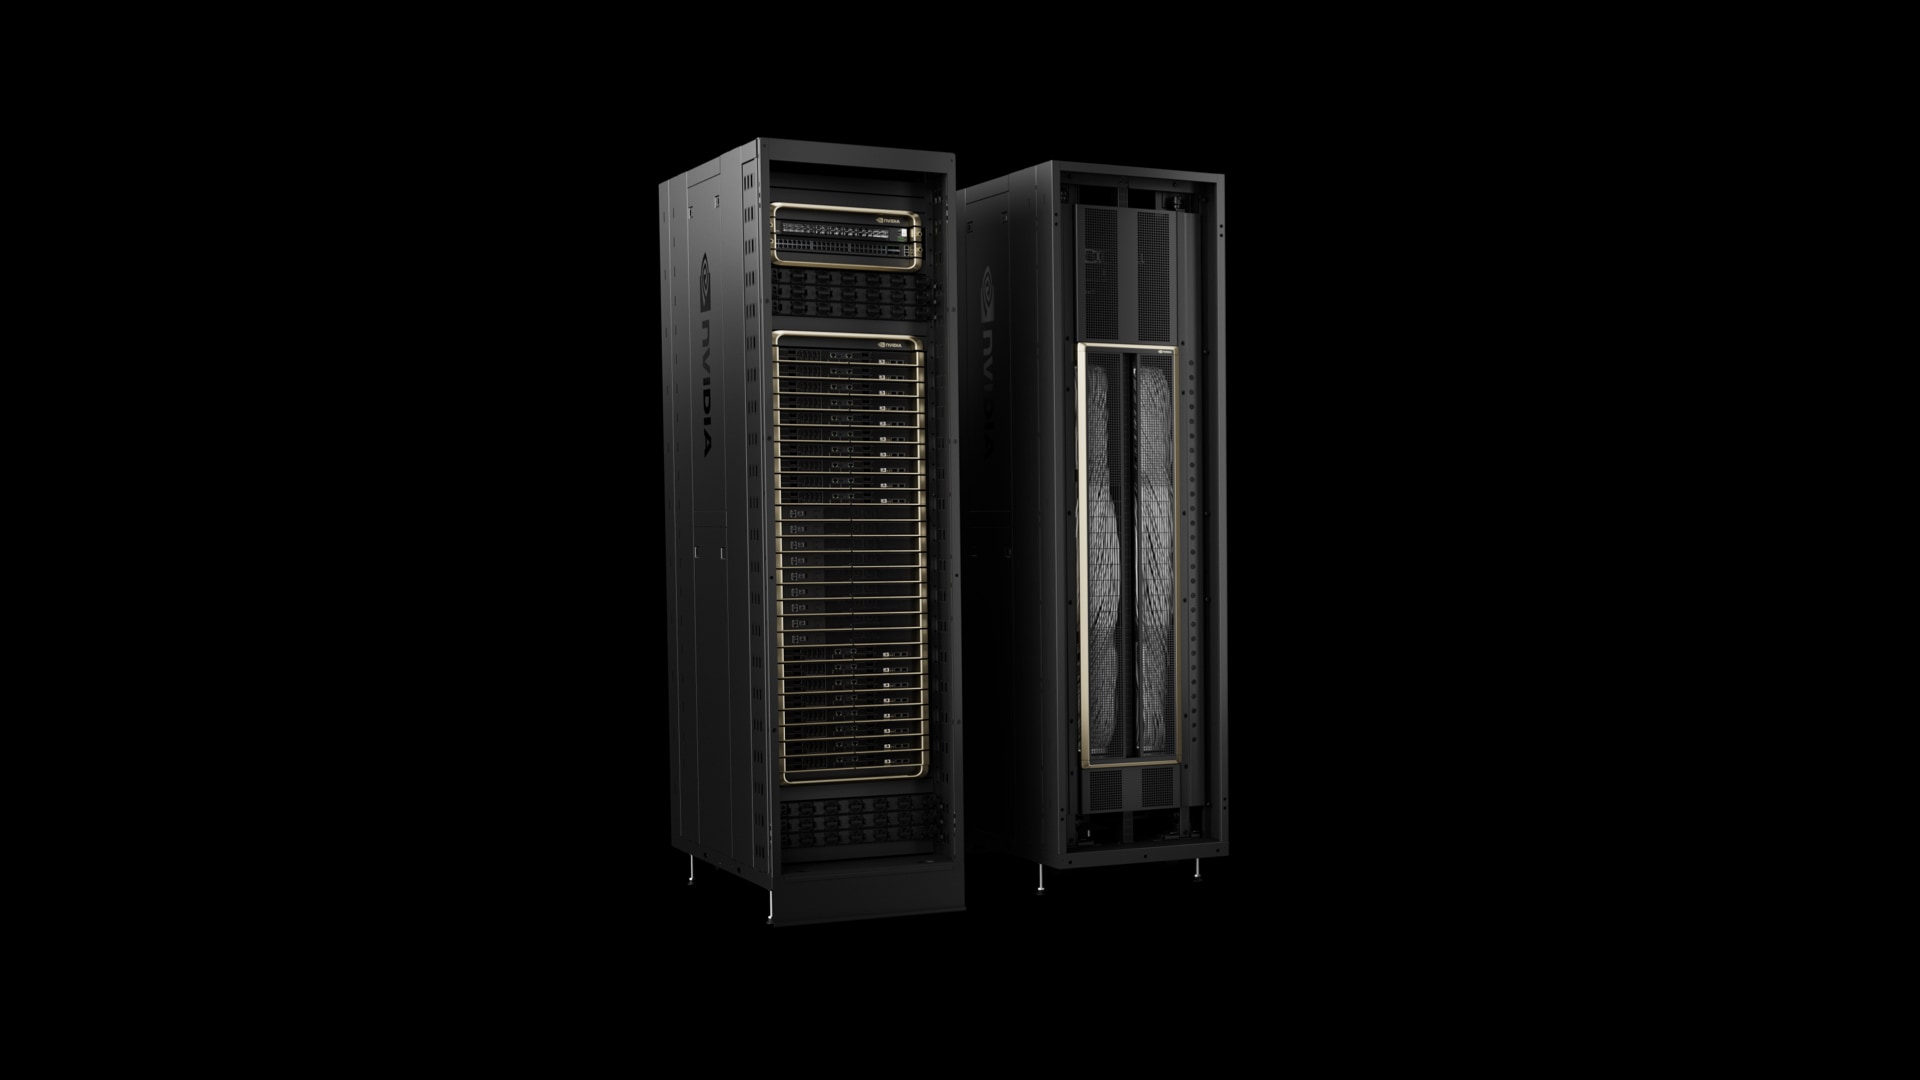
Blackwell et logiciel d’inférence
Le 1er octobre, NVIDIA a détaillé l’infrastructure derrière GPT-6 Astra Ultrafast. Ce mode de service, disponible depuis le 29 septembre, repose sur des GPU Blackwell et sur des optimisations du logiciel d’inférence. Selon NVIDIA, OpenAI utilise ses propres modèles pour tester et améliorer ce logiciel.
Une accélération à replacer dans le workflow
NVIDIA annonce une génération de tokens jusqu’à huit fois plus rapide que le mode Standard. Ce chiffre reste une performance annoncée par le fournisseur, sans benchmark indépendant présenté. Il ne garantit pas qu’une tâche complète, avec recherche, appels d’outils et vérifications, finira dans les mêmes proportions.
Pour les développeurs, l’intérêt se situe surtout dans les séquences répétées de génération, test et correction. OpenAI recommande les connexions WebSocket pour réduire les délais réseau entre les appels.
Prix et traitement régional : deux conditions à vérifier
Dans l’API, le tarif Ultrafast en contexte court est de 60 dollars par million de tokens d’entrée et de 300 dollars en sortie, hors tarifs spécifiques au cache. Ces deux prix sont six fois ceux du mode Standard ; les requêtes classées en contexte long sont facturées davantage.
L’accès API est ouvert pour Astra, avec des limites de débit. L’accès dans Codex et ChatGPT Work dépend des conditions proposées aux utilisateurs éligibles.
Point important pour les équipes européennes : Ultrafast prend en charge le traitement global et la résidence des données aux États-Unis, mais pas les endpoints de traitement régional dans l’Union européenne ou les autres régions hors États-Unis. Avant de l’activer, il faut comparer le temps réellement gagné, le coût et les exigences de résidence.
Commentaires
Chargement…
Préparation de votre espace lecteur…
Chargement des commentaires…