

Des décisions rapides dans un agent
Strands Labs a publié Strands Decider 2B le 1er octobre 2026. Ce projet expérimental de l’écosystème Strands d’AWS se concentre sur une tâche précise : choisir parmi des réponses définies à l’avance, ou attribuer un score à une situation. La version de référence publiée est v19.
Un logiciel peut par exemple lui demander vers quel service diriger une requête ou quel outil sélectionner. Le modèle retourne les probabilités associées aux choix proposés. Cette sortie structurée facilite l’intégration dans une automatisation, mais une réponse conforme au format peut toujours être incorrecte.
Une base Qwen adaptée aux choix fermés
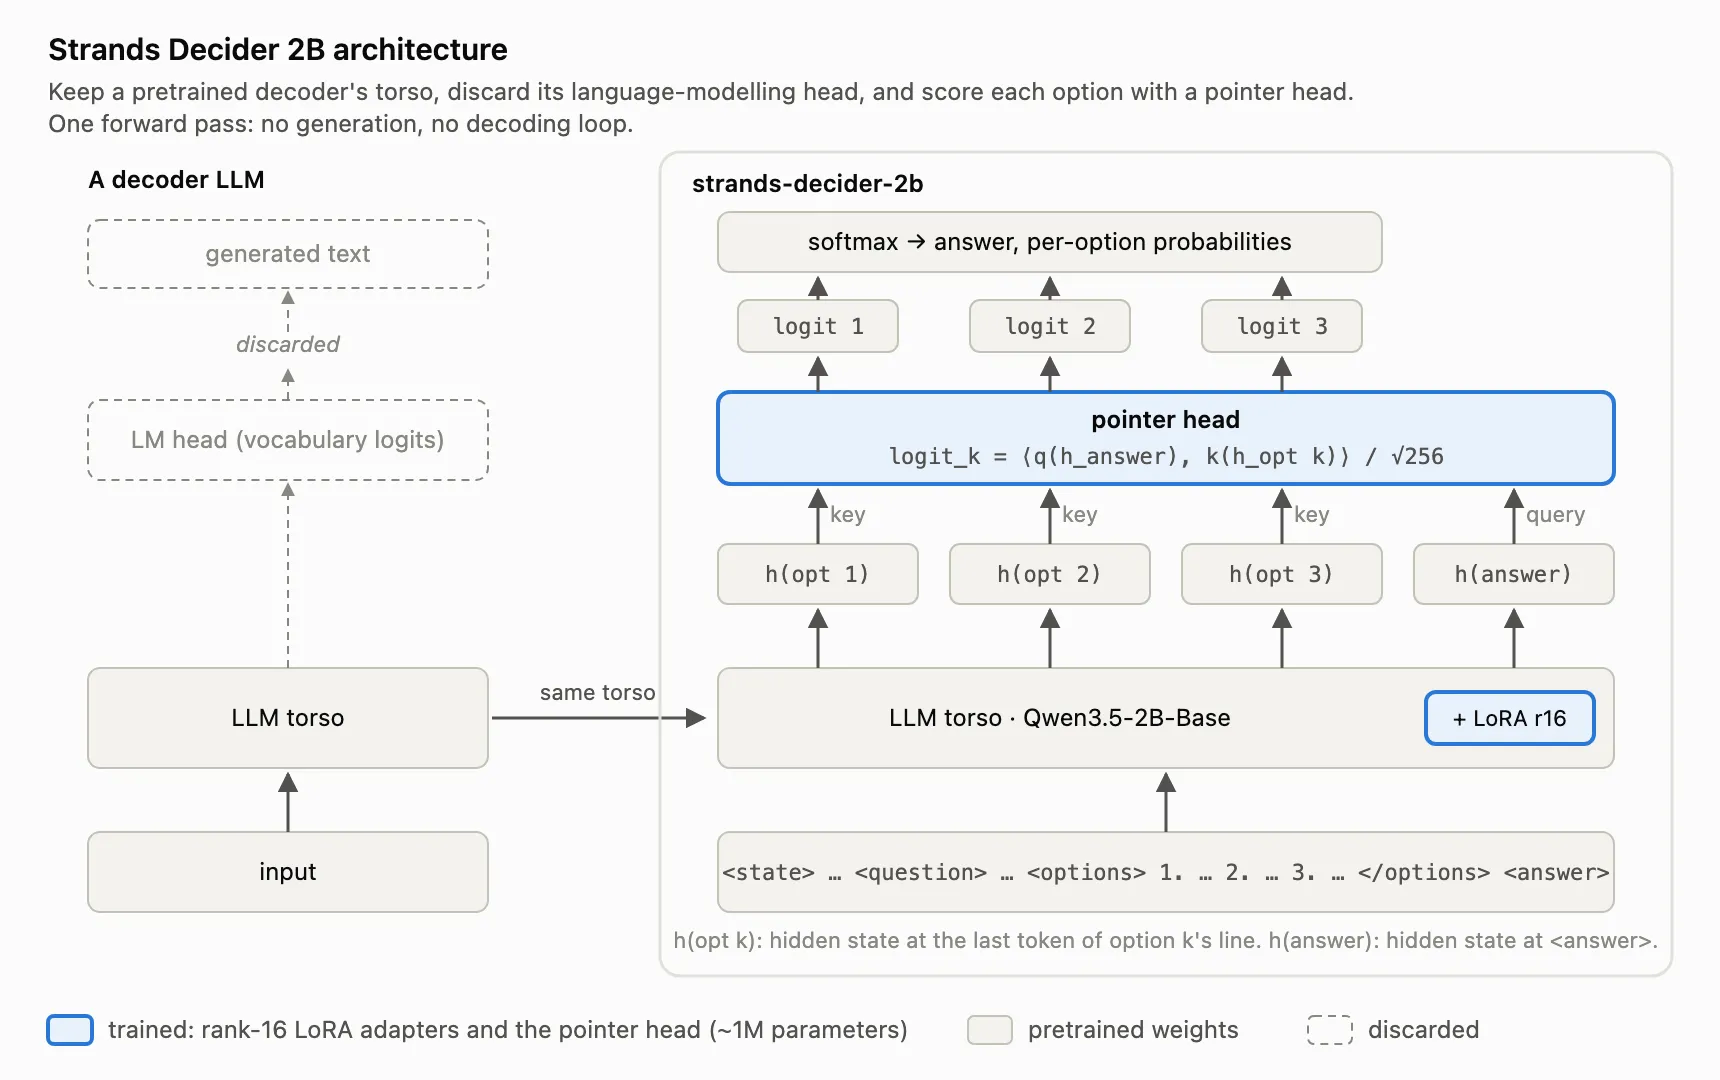
Strands Decider appartient à la classe des modèles d’environ deux milliards de paramètres. Son architecture conserve la base de Qwen3.5-2B et remplace la tête qui produit du texte par une petite tête de sélection. Un adaptateur LoRA complète cet ensemble.
Les options sont évaluées en un seul passage, sans rédaction d’une réponse mot par mot. Cette conception vise les décisions courtes et répétitives. Le modèle ne produit pas de conversation, de code ou de résumé libre.
Un accès local documenté sur PC et Mac
Le code et le modèle officiel sont disponibles sous licence Apache 2.0. Le fichier distribué contient notamment l’adaptateur et la tête de sélection ; les poids de base Qwen sont téléchargés séparément lors de la première utilisation. Une connexion reste donc nécessaire pour récupérer cet ensemble avant de travailler localement.
La documentation décrit l’inférence avec un GPU NVIDIA sous Linux ou WSL2, ainsi que sur les Mac Apple Silicon via MPS. Un mode CPU existe également, avec une exécution nettement plus lente. Ces indications ne constituent pas une configuration minimale validée pour tous les ordinateurs.
Une interface en ligne de commande et un serveur HTTP permettent d’intégrer le modèle à un logiciel. Le serveur fourni écoute sur l’adresse locale de la machine et ne possède pas d’authentification : c’est un point important pour conserver le cadre d’une expérimentation locale.
Ce que disent réellement les mesures de latence
Le dépôt de recherche rapporte pour v19 une médiane de 115 millisecondes par question sur une RTX 3090 sous WSL2, avec un 95e percentile de 299 millisecondes. Ces mesures de l’équipe reposent sur les tâches publiques de JevBench ; Great Opti n’a pas exécuté ce test.
Le résultat Mac demande davantage de contexte. Sur le M3 Pro de 36 Go utilisé par l’équipe, les 153 millisecondes de médiane concernent les requêtes répétées de moins de 300 tokens, après compilation initiale. Sur l’ensemble des tâches, la médiane à chaud monte à 234 millisecondes et le 95e percentile à 2 628 millisecondes.
La longueur de la requête et le premier appel peuvent donc changer sensiblement l’attente. Ces valeurs n’annoncent pas une réponse en une fraction de seconde pour chaque document, chaque machine ou chaque installation.
Le score de confiance a ses limites
La fiche officielle signale plusieurs faiblesses : les documents longs et les problèmes à plusieurs étapes restent difficiles ; certaines questions modifiées obtiennent encore la même réponse ; les tâches oui/non et les barèmes éloignés des données d’entraînement se généralisent mal.
La calibration a été établie sur de courtes tâches de classification. Avant d’utiliser un seuil de confiance pour déclencher une action, il faut en vérifier la pertinence sur les cas réels de l’application. Le score ne fournit pas, à lui seul, une autorisation fiable ou une protection générale contre les erreurs d’un agent.
Un outil pour expérimenter des automatisations locales
L’intérêt de Strands Decider 2B tient à ce périmètre ciblé et à la documentation disponible. Les développeurs peuvent tester un petit composant local pour orienter des demandes ou effectuer des vérifications simples, tout en réservant les problèmes complexes à un système plus adapté.
Pour un usage concret, la bonne vérification porte d’abord sur les erreurs, les formulations de questions et les longueurs de documents rencontrées. Une latence favorable sur un benchmark ne suffit pas à valider toute une automatisation.
Commentaires
Chargement…
Préparation de votre espace lecteur…
Chargement des commentaires…